Was ist KI-Observability? Ein praktischer Leitfaden
9 min read | Published

Die meisten KI-Systeme versagen leise. Ein Chatbot gibt eine falsche Antwort, ein Agent wählt das falsche Tool, oder die monatliche KI-Rechnung verdreifacht sich – und niemand bemerkt es, bis sich ein Kunde beschwert oder die Finanzabteilung nachfragt. KI-Observability (KI-Beobachtbarkeit) bezeichnet die Praxis, das tatsächliche Verhalten von KI-Systemen in der Produktion zu verfolgen, zu messen und zu bewerten: was sie tun, wie gut sie funktionieren und was sie kosten. So werden solche Fehler sichtbar, bevor sie zu Vorfällen werden.
Dieser Leitfaden erläutert, was KI-Observability bedeutet, worin sie sich vom klassischen Software-Monitoring unterscheidet, was Sie zuerst erfassen sollten, wenn Sie bei null beginnen, und wie sich das Konzept in drei praktische Problemstellungen aufteilt, die die meisten Teams früher oder später getrennt lösen müssen.
Das Wichtigste in Kürze
- KI-Observability erfasst das interne Verhalten, die Ergebnisqualität, die Leistung und die Kosten von KI – nicht nur, ob ein System verfügbar ist oder nicht.
- Sie unterscheidet sich von klassischer Software-Observability, weil KI-Systeme nicht deterministisch sind: Dieselbe Eingabe kann unterschiedliche Ausgaben erzeugen.
- Eine ausgereifte Praxis stützt sich auf drei Säulen: Traces (was ist passiert), Evaluierungen (wie gut war das Ergebnis) und Metriken (was hat es gekostet und wie schnell war es).
- „KI-Observability“ (Observability für KI-Systeme) wird oft mit „KI-gestützter Observability“ (Einsatz von KI zur Überwachung der Infrastruktur) verwechselt. Beide lösen unterschiedliche Probleme.
- Beginnen Sie mit Daten zu Akzeptanz und Nutzung (wer nutzt KI, wo und wie viel), bevor Sie in tiefergehendes Tracing investieren.
- KI-Agenten zu entwickeln ist der einfache Teil. Schwierig ist es, nachzuweisen, dass sie korrekt funktionieren, und ihnen genug zu vertrauen, um sie breit einzusetzen – ein Grund dafür, dass bis zu 88 % der Agenten-Pilotprojekte nie in die Produktion gelangen.
Was ist KI-Observability?
KI-Observability ist die Fähigkeit, anhand der Daten, die ein KI-System im Betrieb erzeugt, nachzuvollziehen, was es getan hat, wie gut es funktioniert hat und was es gekostet hat. Sie erweitert die klassische Observability, die Verfügbarkeit, Latenz und Fehler erfasst, auf einen Bereich, in dem Korrektheit und Qualität nicht binär sind. Der Begriff umfasst Observability für generative KI ebenso wie für KI-Systeme im weiteren Sinne – unabhängig davon, ob es sich um einen einzelnen LLM-Aufruf, einen mehrstufigen Agenten oder ein prädiktives Modell handelt.
Eine klassische Anwendung liefert entweder den richtigen Wert oder löst einen Fehler aus. Ein KI-System kann dagegen eine Antwort liefern, die technisch erfolgreich ist (kein Fehler, normale Latenz), und trotzdem falsch, irrelevant oder teuer sein. Klassisches Verfügbarkeits-Monitoring kann das nicht erkennen. KI-Observability schließt diese Lücke, indem sie Transparenzebenen ergänzt, die herkömmliches Monitoring nicht abdeckt.
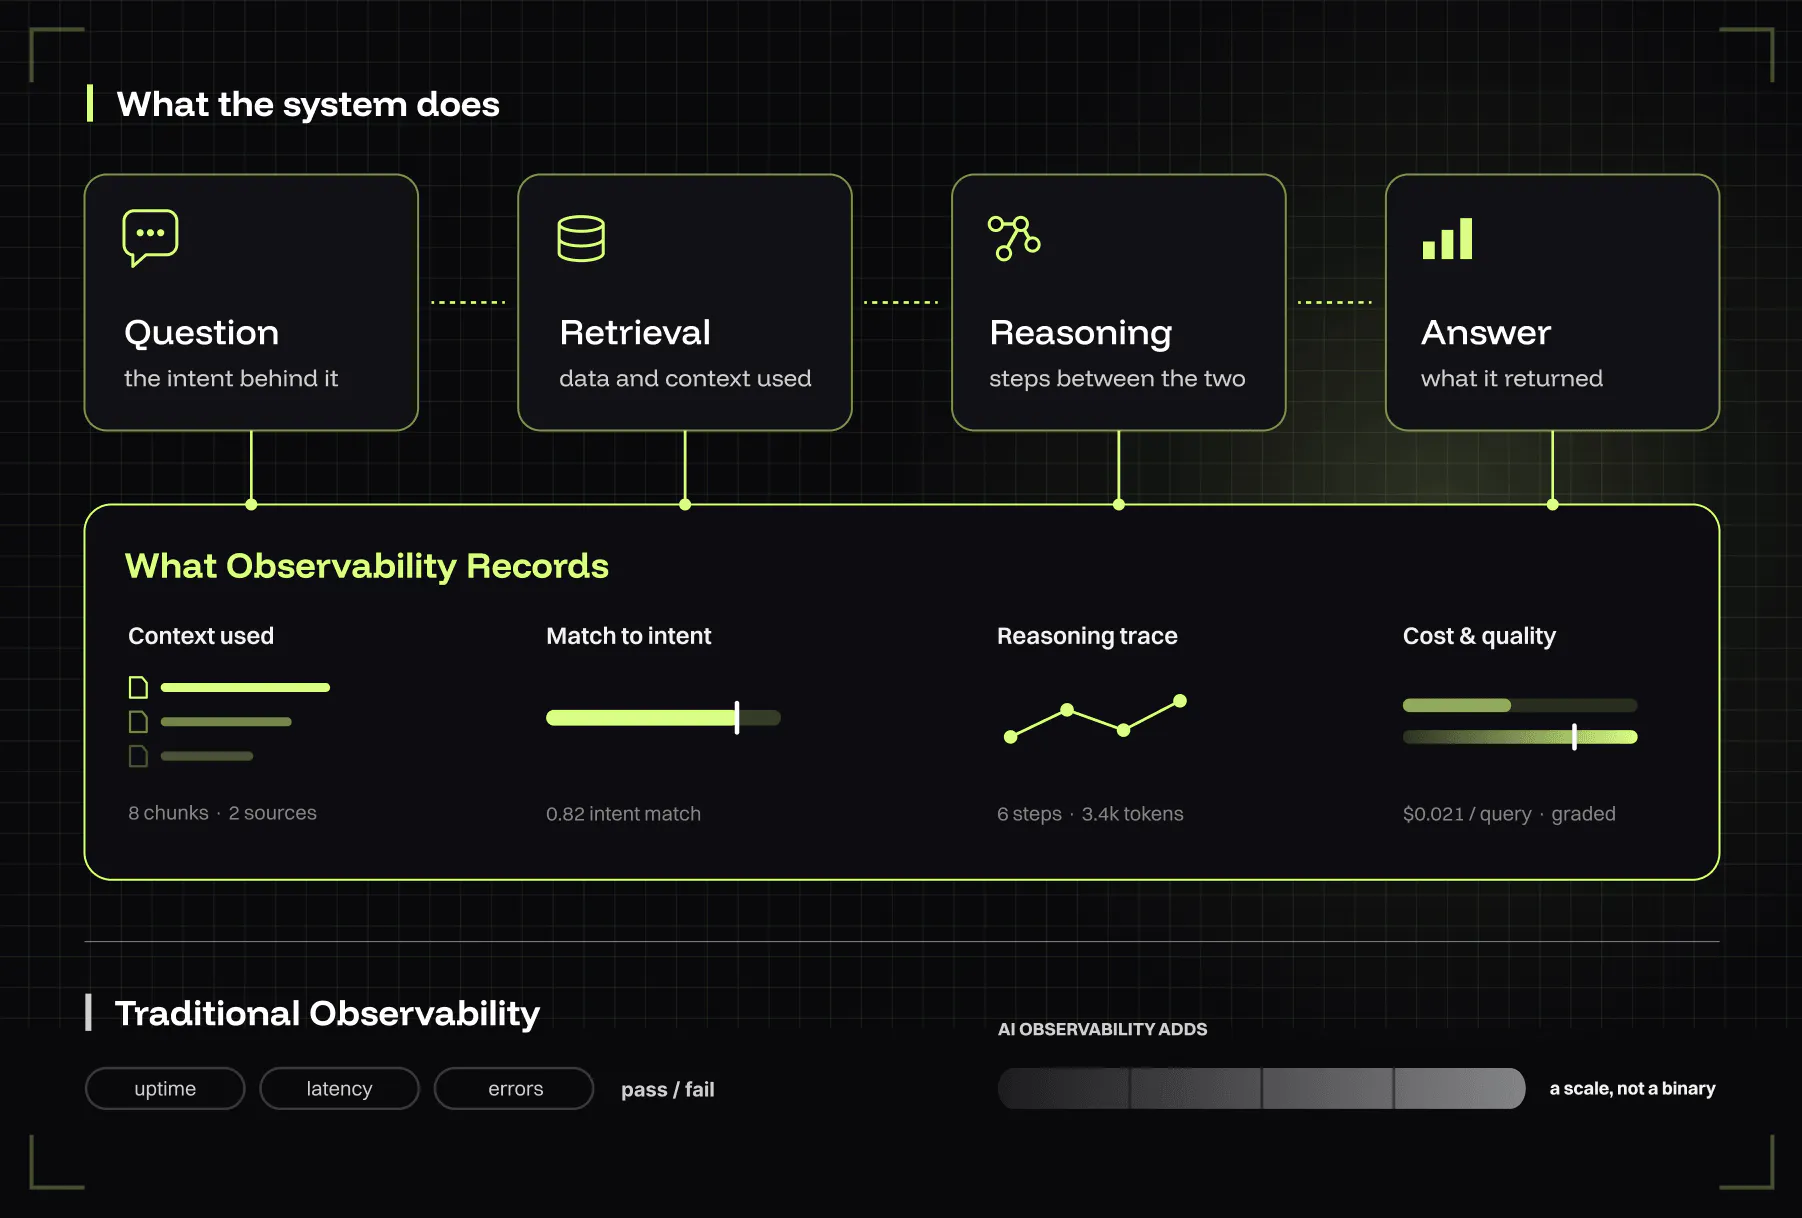
Die drei Transparenzebenen, die KI-Observability ergänzt
Verhalten. Was das System intern tatsächlich getan hat – einschließlich Reasoning-Schritten, Tool-Aufrufen und abgerufenem Kontext –, nicht nur das Endergebnis. Bei einem Agenten bedeutet das zu wissen, dass er eine Wissensdatenbank durchsucht, eine Preis-API aufgerufen und anschließend eine Zusammenfassung erstellt hat, statt nur die Zusammenfassung selbst zu sehen.
Qualität. Ob das Ergebnis korrekt, relevant und nützlich war – in der Regel gemessen über Evaluierungsscores oder Nutzerfeedback. Qualität ergibt sich nicht aus der Abwesenheit eines Fehlers: Eine flüssige, selbstbewusst formulierte, aber falsche Antwort erzeugt überhaupt keinen Fehler.
Kosten. Wie viele Tokens oder Abfragen eine Aufgabe verbraucht hat und was das finanziell bedeutet. Da die Abrechnung nutzungsbasiert erfolgt, steigen die Kosten mit der Akzeptanz auf eine Weise, die ohne gezieltes Tracking leicht aus dem Blick gerät.
Der Unterschied zu klassischem APM
Klassisches Application Performance Monitoring (APM) beantwortet einen engeren Fragenkatalog: Ist der Dienst verfügbar, wie schnell hat er geantwortet, ist ein Fehler aufgetreten? Diese Fragen sind weiterhin wichtig, reichen aber nicht bis zu dem, was tatsächlich darüber entscheidet, ob eine KI-Funktion funktioniert: War das Ergebnis gut, und hat das System den richtigen Weg dorthin gewählt?
Warum KI-Observability für LLMs und Agenten wichtig ist
KI-Observability ist wichtig, weil KI-Systeme auf eine Weise versagen, die klassisches Monitoring nicht erkennen kann – und weil das Risiko deutlich steigt, sobald Agenten autonom handeln, statt nur Text zu generieren.
KI-Systeme sind nicht deterministisch
Derselbe Prompt kann beim selben Modell in verschiedenen Durchläufen unterschiedliche Ausgaben erzeugen. Damit fällt eine Grundannahme klassischer Softwaretests und klassischen Monitorings weg: dass eine bestimmte Eingabe zuverlässig eine bestimmte Ausgabe liefert. Um ein gemeldetes Problem zu reproduzieren, muss ein Team die genaue Eingabe, die Modellversion und die zum Zeitpunkt des Fehlers verwendeten Parameter kennen – und genau diese Daten liefert Observability.
Das hat praktische Konsequenzen. Ein Support-Ticket mit dem Inhalt „Die KI hat mir gestern eine falsche Antwort gegeben“ lässt sich ohne einen Trace genau dieser Interaktion kaum debuggen. Wenn Sie denselben Prompt heute erneut ausführen, erhalten Sie möglicherweise eine korrekte Antwort – und erfahren nichts darüber, was tatsächlich passiert ist.
Agentenbasierte Workflows erhöhen das Risiko
Ein KI-Agent, der plant, Tools auswählt und im Auftrag eines Benutzers handelt, bringt Fehlerquellen mit sich, die ein einfacher Chatbot nicht hat. Gartner prognostiziert, dass bis Ende 2026 40 % der Unternehmensanwendungen aufgabenspezifische KI-Agenten integrieren werden, gegenüber weniger als 5 % im Jahr 2025 (Gartner, 2025). Wenn Agenten nicht mehr nur Fragen beantworten, sondern mehrstufige Aufgaben ausführen, kann ein unbemerkter Fehler bedeuten, dass der falsche Datensatz aktualisiert oder die falsche Aktion ausgeführt wird – und nicht nur, dass eine falsche Antwort auf dem Bildschirm erscheint.
Fehlende Observability ist das größte Hindernis auf dem Weg in die Produktion
Die meisten Unternehmen können heute bereits KI-Agenten entwickeln. Schwieriger ist es, ihnen genug zu vertrauen, um sie breit einzusetzen – denn die meisten Teams können noch nicht zuverlässig nachweisen, dass die Agenten korrekt funktionieren, oder ihr Verhalten in der Produktion überwachen und Fehler beheben. Einer Schätzung zufolge führt diese Lücke dazu, dass bis zu 88 % der KI-Agenten-Pilotprojekte nie in die Produktion gelangen (Anaconda/Forrester, 2026, bestätigt durch a16z und MIT Sloan).
Von Analysten zusammengestellte Studien auf Basis von Daten von Gartner, McKinsey, IDC und Forrester bestätigen dies auf Unternehmensebene: Lücken bei Evaluierung und Observability sind das größte einzelne Hindernis, wenn Unternehmen KI-Agenten vom Pilotprojekt in die Produktion überführen. 64 % der befragten Führungskräfte nennen diesen Punkt, und 70 % bezeichnen nicht deterministische Ausgaben ausdrücklich als ihre größte Sorge in Bezug auf die Produktionsreife.
Diese Kombination aus unvorhersehbarem Verhalten und der begrenzten Möglichkeit, es nachzuweisen oder zu überwachen, macht KI-Observability zu einer Voraussetzung für die Skalierung von KI über Pilotprojekte hinaus – und nicht zu einer optionalen Ergänzung.
Erfahren Sie, wie GoodData.AI Ihnen hilft, Analytik, KI und Agenten auf einer einzigen Plattform zu entwickeln, zu steuern und zu skalieren.
Demo anfordern
Was ohne Observability passiert
Ein typisches Szenario: Ein interner KI-Agent beantwortet Fragen von Mitarbeitenden zu Spesenabrechnungen. Im Laufe einiger Wochen gibt er zunehmend widersprüchliche Antworten zur Erstattungsgrenze für eine bestimmte Ausgabenkategorie.
Ohne Verhaltens-Tracing, Qualitätssignale oder nach Themen aufgeschlüsselte Nutzungsdaten bleibt das Problem möglicherweise unbemerkt, bis sich genügend Mitarbeitende beschweren und jemand manuell eine Stichprobe der Gesprächsprotokolle prüft. Mit Observability zeigt sich derselbe Qualitätsverlust Tage oder Wochen früher als Rückgang des Qualitätsscores für genau dieses Thema – und die betreffenden Interaktionen sind bereits für die Prüfung protokolliert.
KI-Observability vs. KI-gestützte Observability
Die beiden Begriffe klingen ähnlich, beschreiben aber gegensätzliche Dinge. Wer sie verwechselt, evaluiert am Ende möglicherweise völlig ungeeignete Tools.
KI-Observability bedeutet, Observability-Praktiken auf KI-Systeme anzuwenden: zu erfassen, was ein LLM oder Agent tut, wie gut er funktioniert und was er kostet. Das KI-System ist hier das beobachtete Objekt.
KI-gestützte Observability bedeutet, KI zur Verbesserung des klassischen Infrastruktur-Monitorings einzusetzen: Anomalieerkennung, automatisierte Ursachenanalyse oder Priorisierung von Alerts mithilfe von maschinellem Lernen, angewendet auf herkömmliche IT-Systeme. Hier ist KI das Werkzeug, das beobachtet – nicht der Gegenstand der Beobachtung.
| KI-Observability | KI-gestützte Observability | |
|---|---|---|
| Was wird beobachtet | Das KI-System selbst (LLMs, Agenten) | Klassische Infrastruktur (Server, Anwendungen, Netzwerke, Logs) |
| Rolle der KI | Beobachtetes Objekt | Beobachtendes Werkzeug |
| Typische Käufer | Datenteams, KI/ML-Teams, Produktteams, die KI-Funktionen ausliefern | Plattformteams, SRE, IT-Betrieb |
| Beispielfrage | „Warum hat unser Support-Agent eine widersprüchliche Antwort gegeben?“ | „Warum ist die Latenz in unserem Kubernetes-Cluster sprunghaft gestiegen?“ |
| Beispielhafte Anbieterkategorie | LLM-Tracing- und Agenten-Observability-Tools (z. B. Langfuse, Arize) | AIOps-Plattformen (Dynatrace Davis AI, Splunk AI) |
Ein Plattformteam, das Kubernetes-Cluster mit KI-gestützter Anomalieerkennung überwacht, nutzt KI-gestützte Observability. Ein Datenteam, das untersucht, warum sein Kundensupport-Agent eine widersprüchliche Antwort gegeben hat, betreibt KI-Observability. Tools, Käufergruppen und erforderliche Kompetenzen unterscheiden sich weitgehend, auch wenn beide Bereiche das Wort „Observability“ verwenden.
Prüfen Sie bei der Recherche zu Anbietern oder beim Lesen von Analystenberichten, welche Definition gemeint ist. Ein Tool für KI-gestütztes Infrastruktur-Monitoring hilft Ihnen nicht dabei nachzuvollziehen, was ein LLM-Agent bei einer fehlgeschlagenen Aufgabe getan hat. Umgekehrt ersetzt ein LLM-Tracing-Tool nicht Ihren Monitoring-Stack für die Infrastruktur.
Drei Perspektiven, die Sie kennen sollten
Bei KI-Observability geht es in der Regel um drei praktische Fragen: Was tut der Agent? Wie wird KI im gesamten Unternehmen genutzt? Und brauchen Sie überhaupt ein separates Observability-Tool?
Das Verhalten von Agenten verstehen
Sobald ein KI-Agent Tools aufrufen, Daten abrufen und mehrere Schritte zur Erledigung einer Aufgabe durchlaufen kann, wird es ebenso wichtig zu verstehen, was er getan hat, wie das, was er geantwortet hat.
Tracing-Frameworks wie die OpenTelemetry GenAI Semantic Conventions tragen dazu bei, diesen Prozess zu standardisieren. Tool-Aufrufe, Modellaufrufe und Retrieval-Schritte lassen sich als nachverfolgbare Ereignisse erfassen, sodass eine Aufzeichnung darüber entsteht, wie der Agent eine Aufgabe ausgeführt hat (Greptime, 2026).
Das ist besonders beim Debugging hilfreich. Wenn ein Agent ein falsches Ergebnis liefert oder eine falsche Aktion ausführt, lautet die entscheidende Frage nicht nur, was schiefgelaufen ist, sondern wo. Hat er das falsche Tool gewählt? Die falschen Daten abgerufen? Ist ein bestimmter Schritt fehlgeschlagen?
Ohne diese Transparenz bleibt Teams oft nichts anderes übrig, als Prompts zu reproduzieren und zu raten, was passiert ist. Einen tieferen Einblick in Tracing-Standards und das Debugging von Agenten bietet der Artikel KI-Agenten-Observability.
Governance, Compliance und Kostentransparenz
Mit wachsender KI-Nutzung brauchen Unternehmen außerdem Transparenz darüber, wie KI eingesetzt wird: wer sie nutzt, in welchen Umgebungen oder Workspaces, wie häufig und zu welchen Kosten.
Dies ist oft eine der ersten praktischen Governance-Anforderungen, mit denen Unternehmen konfrontiert werden. Bevor sie sich mit umfassenderen regulatorischen Rahmenwerken wie dem EU-KI-Gesetz oder dem NIST AI Risk Management Framework befassen, benötigen Teams ein klares Bild der KI-Aktivitäten im gesamten Unternehmen.
Die Kosten sind Teil dieser Transparenz. Bei nutzungsbasierter KI-Abrechnung kann ein einzelner Workspace, eine einzelne Anwendung oder ein einzelner Benutzer einen unverhältnismäßig großen Anteil des Verbrauchs verursachen. Ohne Aufschlüsselung der Nutzung werden solche Muster möglicherweise erst sichtbar, wenn die Gesamtrechnung steigt.
Wie Transparenz über die KI-Nutzung Governance und Kostenkontrolle unterstützt, erfahren Sie im Artikel KI-Governance beginnt mit dem Wissen, wer KI nutzt.
Brauchen Sie ein separates Observability-Tool?
Nicht jedes Unternehmen benötigt eine dedizierte KI-Observability-Plattform.
Wenn Ihre KI-Agenten oder KI-gestützten Funktionen bereits in einer bestehenden Analyse- oder Anwendungsplattform laufen, lohnt es sich zu prüfen, welche Transparenz diese Plattform bereits bietet, bevor Sie ein weiteres Tool einführen.
Dedizierte Observability-Produkte sind vor allem für Teams sinnvoll, die eigene LLM-Anwendungen über mehrere Modelle, Tools und Dienste hinweg entwickeln und keine einzelne Plattform mit zentraler Transparenz haben.
Bei Teams, deren KI-Funktionen bereits in einer Analyse- oder BI-Plattform laufen, sind einige der benötigten Nutzungs- und Interaktionsdaten möglicherweise schon vorhanden. Entscheidend ist, ob die Plattform genug davon bereitstellt, um Monitoring, Fehlerbehebung, Governance und Kostenanalyse zu unterstützen.
Ein umfassenderes Entscheidungsframework finden Sie im Artikel KI-Observability-Tools: Brauchen Sie ein separates Tool?
Wer KI-Observability braucht
Daten- und Analytics-Verantwortliche benötigen KI-Observability, um Fragen zu Governance und Budget zu beantworten: Wer nutzt KI, schafft sie Mehrwert, und was kostet sie im gesamten Unternehmen? Diese Zielgruppe fragt in der Regel als erste nach Nutzungstransparenz – lange bevor jemand tiefgehendes Verhaltens-Tracing verlangt. Sie entscheidet auch, welche Änderungen auf Basis der Observability-Daten priorisiert werden.
Data Engineers und Datenarchitekten benötigen sie, um KI-Funktionen direkt zu debuggen und zu verbessern: nachzuvollziehen, warum ein Agent fehlgeschlagen ist, Prompts anhand von Evaluierungsscores zu optimieren und neue KI-Funktionen so zu instrumentieren, dass sie vom ersten Tag an beobachtbar sind, statt später nachgerüstet zu werden.
Produktteams, die KI-gestützte Funktionen ausliefern, brauchen genug Transparenz, um zu erkennen, ob eine Funktion tatsächlich angenommen wird und ob sich die Signale aus dem Nutzerfeedback nach einer Änderung verbessern oder verschlechtern. Für diese Zielgruppe ist die Akzeptanz das zentrale Observability-Signal: Sie zeigt, ob eine ausgelieferte Funktion funktioniert, und bestimmt, was als Nächstes geändert werden sollte.
Checkliste für den Einstieg in KI-Observability
Die meisten Teams müssen nicht vom ersten Tag an alles instrumentieren. Beginnen Sie mit der Kategorie, die die dringendste Frage in Ihrem Unternehmen beantwortet, und bauen Sie von dort aus weiter aus. Diese fünf Kategorien decken ab, was eine ausgereifte KI-Observability-Praxis erfasst.
Akzeptanz und Nutzung. Wer nutzt KI, in welchen Workspaces oder Teams und wie oft? Diese Kategorie lässt sich meist am schnellsten umsetzen, da sie keine tiefgehende Instrumentierung des KI-Systems selbst erfordert, sondern nur Transparenz darüber, wer es auslöst. Ein sinnvoller erster Meilenstein: ein einzelnes Dashboard mit aktiven Benutzern, aktiven Workspaces und der Gesamtzahl der KI-Aktionen im laufenden Monat.
Leistung. Wie schnell die KI antwortet, von Anfang bis Ende. Die Latenz beeinflusst sowohl die Nutzererfahrung als auch – bei agentenbasierten Workflows – die Dauer einer mehrstufigen Aufgabe. Erfassen Sie sie pro Interaktion und nicht nur als systemweiten Durchschnitt, denn ein einzelner langsamer Tool-Aufruf kann einen ansonsten schnellen Agenten ausbremsen.
Ergebnisqualität. Ob die Antworten der KI korrekt, relevant und nützlich sind. Teams erfassen dies in der Regel über automatisierte Evaluierungsscores, Stichproben mit menschlicher Prüfung oder direkte Feedbacksignale wie Daumen hoch/runter. Eine Kennzahl zur Rate negativen Feedbacks, über die Zeit verfolgt und nach Thema oder Agent aufgeschlüsselt, ist meist der schnellste Weg, einen Qualitätsrückgang zu erkennen, bevor er zu einer Support-Eskalation wird.
Agentenverhalten. Was das System intern getan hat, um zu seiner Antwort zu gelangen: welche Tools es aufgerufen hat, welche Daten es abgerufen hat und wie viele Schritte oder Iterationen es benötigt hat. Dadurch wird aus einer fehlgeschlagenen Aufgabe statt eines Rätsels ein behebbarer Fehler. Diese Kategorie erfordert in der Regel die tiefste Instrumentierung der fünf, da ein vollständiger Trace erfasst werden muss und nicht nur ein Eingabe-Ausgabe-Paar.
Kosten. Abfrage- und Token-Kosten, aufgeschlüsselt nach Workspace, Agent oder Benutzer. Durch die tokenbasierte Abrechnung steigen die Kosten mit der Nutzung auf eine Weise, die ohne gezieltes Tracking leicht aus dem Blick gerät. Schon eine grobe Aufschlüsselung – Kosten pro Workspace und Monat – reicht aus, um ausufernde Nutzung zu erkennen, bevor sie zur bösen Überraschung im Budget wird.
Die meisten Teams beginnen mit Akzeptanz und Nutzung, da diese Kategorie die unmittelbarste Frage im Unternehmen beantwortet („Nutzt das überhaupt jemand, und wo?“). Die anderen vier bauen sie schrittweise aus, während sich die KI-Nutzung vom Pilotprojekt zur Produktion entwickelt.
Wie GoodData.AI Transparenz über die KI-Nutzung heute umsetzt
GoodData.AI versteht Transparenz über die KI-Nutzung als Teil der Analyseumgebung selbst und nicht als separate Datenpipeline für Governance.
GoodData.AI Observability bietet Organisationsadministratoren und Analytics Engineers eine vorkonfigurierte Übersicht über die KI-Aktivitäten in ihrer GoodData-Organisation. Erfasst werden Akzeptanz und Nutzung über Benutzer und Workspaces hinweg, Konversationen, Agentenaktivitäten, Zuverlässigkeit, Fehler und Timeouts, Token-Verbrauch sowie Nutzungstrends.
Die Observability-Daten werden automatisch erfasst, während Benutzer mit den KI-Funktionen von GoodData arbeiten, und in einem standardmäßigen GoodData-Workspace bereitgestellt. Teams können so die verwalteten Dashboards erkunden, die Daten filtern oder die bereitgestellten Analysen um eigene Kennzahlen und Visualisierungen erweitern.
Damit entsteht eine solide operative Grundlage für KI-Governance: Teams sehen, wo KI angenommen wird, welche Benutzer und Workspaces Aktivität erzeugen, wie verschiedene Agenten genutzt werden und wo ungewöhnlich hoher Token-Verbrauch oder Zuverlässigkeitsprobleme auftreten.
Wie geht es weiter?
KI-Observability ist keine einzelne Tool-Entscheidung. Sie ist eine Praxis, die sich aus drei separaten Fragen zusammensetzt: Wie verhalten sich Ihre Agenten tatsächlich? Wer nutzt KI, und was kostet sie? Und brauchen Sie ein dediziertes Tool, oder ist die nötige Transparenz in Ihrer bestehenden Plattform bereits vorhanden? Die meisten Teams kommen weiter, wenn sie diese Fragen nacheinander beantworten, statt zu versuchen, alles auf einmal zu instrumentieren.
Beginnen Sie mit der obigen Checkliste. Allein die Daten zu Akzeptanz und Nutzung beantworten die Frage, die sich die meisten Unternehmen zuerst stellen – und sie lassen sich am schnellsten und ohne neue Infrastruktur bereitstellen.
Wenn Sie prüfen, wie Sie diese Transparenz ohne zusätzlichen Observability-Stack erreichen können, erfahren Sie hier, wie die Agentic-Analytik-Plattform von GoodData.AI die KI-Nutzung ohne zusätzliche Einrichtung sichtbar macht. Oder fordern Sie eine Demo an, um die Plattform in Aktion zu erleben.
Erfahren Sie, wie GoodData.AI Ihnen hilft, Analytik, KI und Agenten auf einer einzigen Plattform zu entwickeln, zu steuern und zu skalieren.
Demo anfordern
Häufig gestellte Fragen
MLOps-Monitoring erfasst in der Regel Leistungskennzahlen wie Accuracy Drift oder Data Drift für ein trainiertes Modell in der Produktion. KI-Observability ist breiter angelegt: Sie umfasst auch LLMs und Agenten, die nicht unbedingt intern trainiert wurden, und ergänzt Qualitätskennzahlen um Verhaltens-Tracing (was hat das System getan) und Kosten-Tracking.
Nicht unbedingt. Wenn Ihre KI-Funktionen bereits in einer Plattform laufen, die Daten zu Nutzung, Leistung und Kosten erfasst, prüfen Sie zunächst, was diese Plattform bereits bereitstellt, bevor Sie ein separates Tool einführen. Dedizierte Tools sind vor allem für Teams sinnvoll, die eigene LLM-Anwendungen außerhalb einer bestehenden Plattform entwickeln.
Mindestens: Akzeptanz und Nutzung (wer, wo, wie oft), Leistung (Antwortlatenz), Ergebnisqualität (Korrektheit und Relevanz), Agentenverhalten (Tool-Aufrufe und Reasoning-Schritte) und Kosten (Tokens und Abfragen). Die meisten Teams beginnen mit Akzeptanz und Nutzung und bauen von dort aus weiter aus.
Nutzungstransparenz ist in der Regel der erste praktische Schritt zur KI-Governance: zu wissen, wer KI nutzt und in welchem Umfang. Sie unterstützt die Compliance-Arbeit im Rahmen von Regelwerken wie dem EU-KI-Gesetz oder dem NIST AI Risk Management Framework. Nutzungstransparenz allein bedeutet jedoch noch keine vollständige Einhaltung einer bestimmten Regulierung.
LLM-Observability ist ein Teilbereich der KI-Observability, der sich speziell auf Aufrufe großer Sprachmodelle konzentriert: Prompts, Completions, Token-Verbrauch und Latenz auf Modellebene. KI-Observability ist die übergeordnete Kategorie, die zusätzlich Agentenverhalten, mehrstufige Workflows sowie Nutzung und Kosten auf Systemebene umfasst.
KI-Observability wendet Observability-Praktiken auf KI-Systeme an (die KI wird beobachtet). KI-gestützte Observability nutzt KI, um das Monitoring klassischer Infrastruktur zu verbessern (die KI beobachtet). Beide adressieren unterschiedliche Probleme und erfordern in der Regel unterschiedliche Tools.
Traces (eine schrittweise Aufzeichnung dessen, was ein KI-System während einer Interaktion getan hat), Evaluierungen (Qualitätsbewertungen der Ergebnisse) und Metriken (aggregierte Werte wie Latenz, Kosten und Feedbackrate, die über die Zeit verfolgt werden). Traces zeigen, was passiert ist, Evaluierungen zeigen, ob es gut war, und Metriken zeigen den Trend.
Das ist unterschiedlich. In der Regel verantworten Daten- und Analytics-Verantwortliche den Bereich Governance und Kostentransparenz, während Data Engineers oder das Team, das die KI-Funktion entwickelt, für Verhaltens-Tracing und Qualitätsevaluierung zuständig sind. In kleineren Unternehmen übernimmt häufig ein einziges Team alle Aufgaben.