KI-Agenten-Observability: Warum sie in Ihre Analyseplattform gehört und nicht in ein separates Tool
7 min read | Published

Ein KI-Agent, der einen Termin bucht, einen Datensatz aktualisiert oder einen Workflow auslöst, riskiert nicht nur eine falsche Antwort, sondern eine falsche Aktion. KI-Agenten-Observability, manchmal auch als Agentic-KI-Observability bezeichnet, ist die Praxis, Schritt für Schritt nachzuverfolgen, was ein Agent tatsächlich getan hat. So wird ein schlechtes Ergebnis zu einem nachvollziehbaren Fehler statt zu einem Rätsel. Dieser Leitfaden erläutert, was Agenten-Observability bedeutet, worin sie sich von LLM-Observability unterscheidet, auf welchen Tracing-Standards sie beruht und warum die Plattform, auf der Ihre Agenten bereits laufen, oft der schnellste Weg dorthin ist.
Einen umfassenderen Überblick über KI-Observability (KI-Beobachtbarkeit) für LLMs, Agenten und die Governance der KI-Nutzung bietet der Artikel Was ist KI-Observability? Ein praktischer Leitfaden.
Das Wichtigste in Kürze
- KI-Agenten-Observability erfasst den Ausführungspfad eines Agenten und nicht nur sein Endergebnis: welche Tools er aufgerufen hat, welche Daten er abgerufen hat und wie viele Schritte er benötigt hat.
- Agenten versagen anders als LLM-Anwendungen mit einzelnen Aufrufen, da sie mehrere Entscheidungen miteinander verketten. Ein einziger falscher Schritt kann so in einer falschen Aktion münden.
- Die entstehenden GenAI Semantic Conventions von OpenTelemetry bieten eine herstellerneutrale Grundlage für das Tracing von Modellaufrufen, Agenten, Tool-Nutzung, Retrieval und weiteren GenAI-Operationen. Zusätzliche Konventionen für Bereiche wie Memory und den Agenten-Lebenszyklus befinden sich noch in Entwicklung.
- Nachträglich angebundenen Observability-Tools fehlt häufig der Nutzungs- und Workspace-Kontext, über den die Plattform, auf der der Agent läuft, bereits verfügt.
- Beginnen Sie mit Instrumentierung und Evaluierungs-Gates, bevor ein Agent in Produktion geht – nicht erst nach dem ersten Vorfall.
Was ist KI-Agenten-Observability?
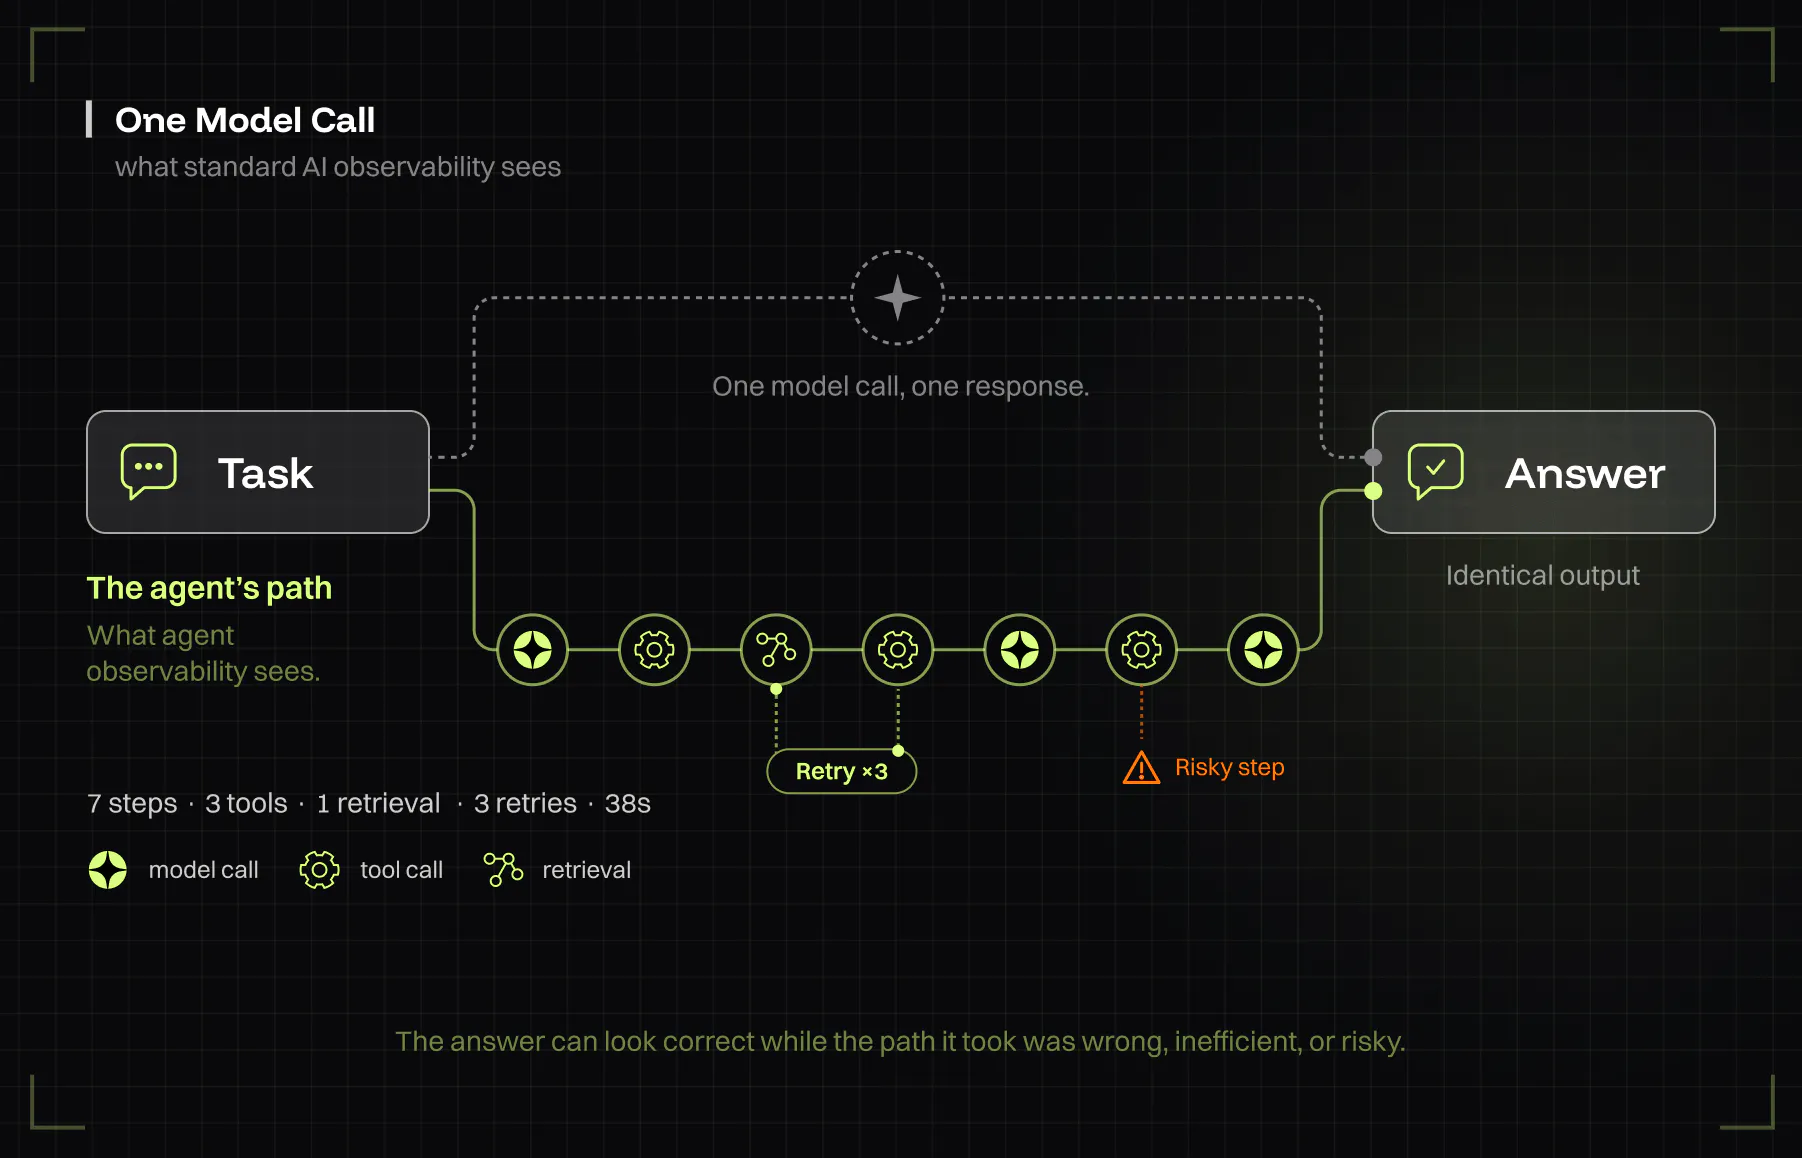
KI-Agenten-Observability ist die Fähigkeit, nachzuvollziehen, was ein KI-Agent intern getan hat, während er eine Aufgabe erledigte: welche Tools er aufgerufen hat, welche Daten er abgerufen hat, welche Schlussfolgerungen er zwischen Modellaufrufen, Retrievals und Tool-Aufrufen gezogen hat und wie viele Iterationen er bis zum Ergebnis benötigt hat. Sie geht über einfache KI-Observability hinaus, die sich auf die Erfassung eines einzelnen Modellaufrufs beschränken kann. Denn das Ergebnis eines Agenten ist das Produkt einer Kette von Entscheidungen und nicht einer einzelnen Antwort.
Diese Unterscheidung ist wichtig, weil die finale Antwort eines Agenten korrekt aussehen kann, obwohl der Weg dorthin falsch, ineffizient oder riskant war. Ein Support-Agent, der am Ende den richtigen Erstattungsbetrag nennt, dafür aber zuerst den Datensatz eines falschen Kunden aufgerufen hat, ist keine Erfolgsgeschichte. Es handelt sich um einen Vorfall, der nur noch nicht bemerkt wurde.
Worin sich Agenten-Observability von LLM-Observability unterscheidet
LLM-Observability erfasst einen einzelnen Aufruf eines Sprachmodells: den Prompt, die Completion, den Token-Verbrauch und die Latenz dieses einen Austauschs. Agenten-Observability erfasst alles rund um diesen Aufruf: für welches Tool sich der Agent entschieden hat, was er vor dem Generieren einer Antwort abgerufen hat, ob er in einer Schleife einen neuen Versuch gestartet hat und wie sich die einzelnen Teile zu einer finalen Aktion verketten.
Der praktische Unterschied zeigt sich beim Debugging. Liefert ein einzelner LLM-Aufruf eine falsche Antwort, kann das Problem im Prompt, im abgerufenen Kontext, in der Modellkonfiguration oder in der Anwendungslogik liegen. Führt ein Agent nach fünf Schritten eine falsche Aktion aus, kann die Ursache in jedem dieser fünf Schritte liegen. Ohne einen Trace jedes einzelnen Schritts bleibt einem Team nur, den Fehler manuell zu reproduzieren und zu raten, wo er entstanden ist.
Agenten bringen außerdem Fehlerbilder mit sich, die bei reinen LLM-Aufrufen nicht auftreten: Schleifen, in denen dasselbe Tool immer wieder aufgerufen wird, ohne dass es vorangeht, die Wahl des falschen Tools für eine Aufgabe oder der Verlust des Kontexts über eine lange Kette von Schritten hinweg. Nichts davon ist in einem Trace auf Modellebene sichtbar, der nur die finale Eingabe und Ausgabe erfasst.
Zentrale Bausteine: Tracing, Tool-Aufrufe und mehrstufiges Reasoning
Eine funktionierende Agenten-Observability-Praxis stützt sich auf drei technische Bausteine, die der tatsächlichen Ausführung von Aufgaben durch Agenten entsprechen. Alle drei gehören zur Säule „Traces“ des übergeordneten Frameworks aus Traces, Evaluierungen und Metriken, das in der KI-Observability insgesamt verwendet wird. Bei Agenten trägt das Tracing die Hauptlast, da sich ein einzelner falscher Schritt zu einer falschen Aktion auswachsen kann. Evaluierungen und Metriken bleiben dennoch wichtig – beide werden in den Best Practices weiter unten behandelt.
Den vollständigen Entscheidungspfad nachverfolgen
Ein aussagekräftiger Agenten-Trace enthält in der Regel mehrere zusammenhängende Spans, die Modellaufrufe, Tool-Aufrufe, Retrievals und Orchestrierungsschritte in der Reihenfolge ihres Auftretens abbilden. So kann ein Team genau rekonstruieren, was der Agent getan hat, und nicht nur, was er am Ende zurückgegeben hat. Die GenAI Semantic Conventions von OpenTelemetry definieren bereits standardisierte Attribute für GenAI-Operationen, während weitere agenten- und workflowspezifische Konventionen in OpenTelemetry und der breiteren Observability-Community weiterentwickelt werden.
Tool-Aufrufe als vollwertige Ereignisse
Jeder Tool-Aufruf eines Agenten – ob Datenbankabfrage, API-Aufruf oder Aufruf eines anderen Agenten – ist ein eigenständiges Ereignis, das ein eigenes Tracing verdient: was aufgerufen wurde, welche Argumente übergeben wurden, was zurückkam und wie lange es gedauert hat. Die entstehenden GenAI-Konventionen behandeln die Tool-Ausführung zunehmend als vollwertige, beobachtbare Operation – einschließlich des aufgerufenen Tools, relevanter Argumente und Ergebnisse, der Dauer und etwaiger Fehler. Ohne diesen Detailgrad zeigt eine fehlgeschlagene Aufgabe nur, dass etwas schiefgelaufen ist, nicht aber, welcher Tool-Aufruf die Ursache war.
Mehrstufiges Reasoning und Memory
Bei Agenten, die über mehrere Schritte hinweg planen oder auf das Memory aus einem früheren Teil einer Konversation zurückgreifen, muss der Zustand fortlaufend erfasst werden – nicht nur zu Beginn und am Ende einer Aufgabe. Erst diese Erfassung macht es möglich zu beantworten, bei welchem Schritt das Reasoning des Agenten fehlgeschlagen ist, statt nur, ob der Agent die richtige Antwort geliefert hat. Community-Vorschläge befassen sich zudem mit Konventionen für die Beobachtung von Memory-Operationen und des Agenten-Lebenszyklus. Diese Bereiche sind jedoch weniger ausgereift als die Kerntelemetrie für Modell- und Tool-Aufrufe.
Erfahren Sie, wie GoodData.AI Ihnen hilft, Analytik, KI und Agenten auf einer einzigen Plattform zu entwickeln, zu steuern und zu skalieren.
Demo anfordern
Warum nachträglich angebundenen Observability-Tools der Kontext fehlt, den Ihre Analyseplattform bereits hat
Die meisten Tools für KI-Agenten-Observability sind darauf ausgelegt, einen Agenten von außen zu instrumentieren: ein SDK hinzufügen, Traces an ein neues Backend weiterleiten und sie in einem neuen Dashboard anzeigen. Das funktioniert, beginnt aber bei null. Anwendungsspezifischer Kontext wie der Workspace des Benutzers, seine Berechtigungen, das semantische Modell oder der Mandant steht nicht automatisch zur Verfügung, sofern er nicht explizit instrumentiert und an das Observability-System übergeben wird.
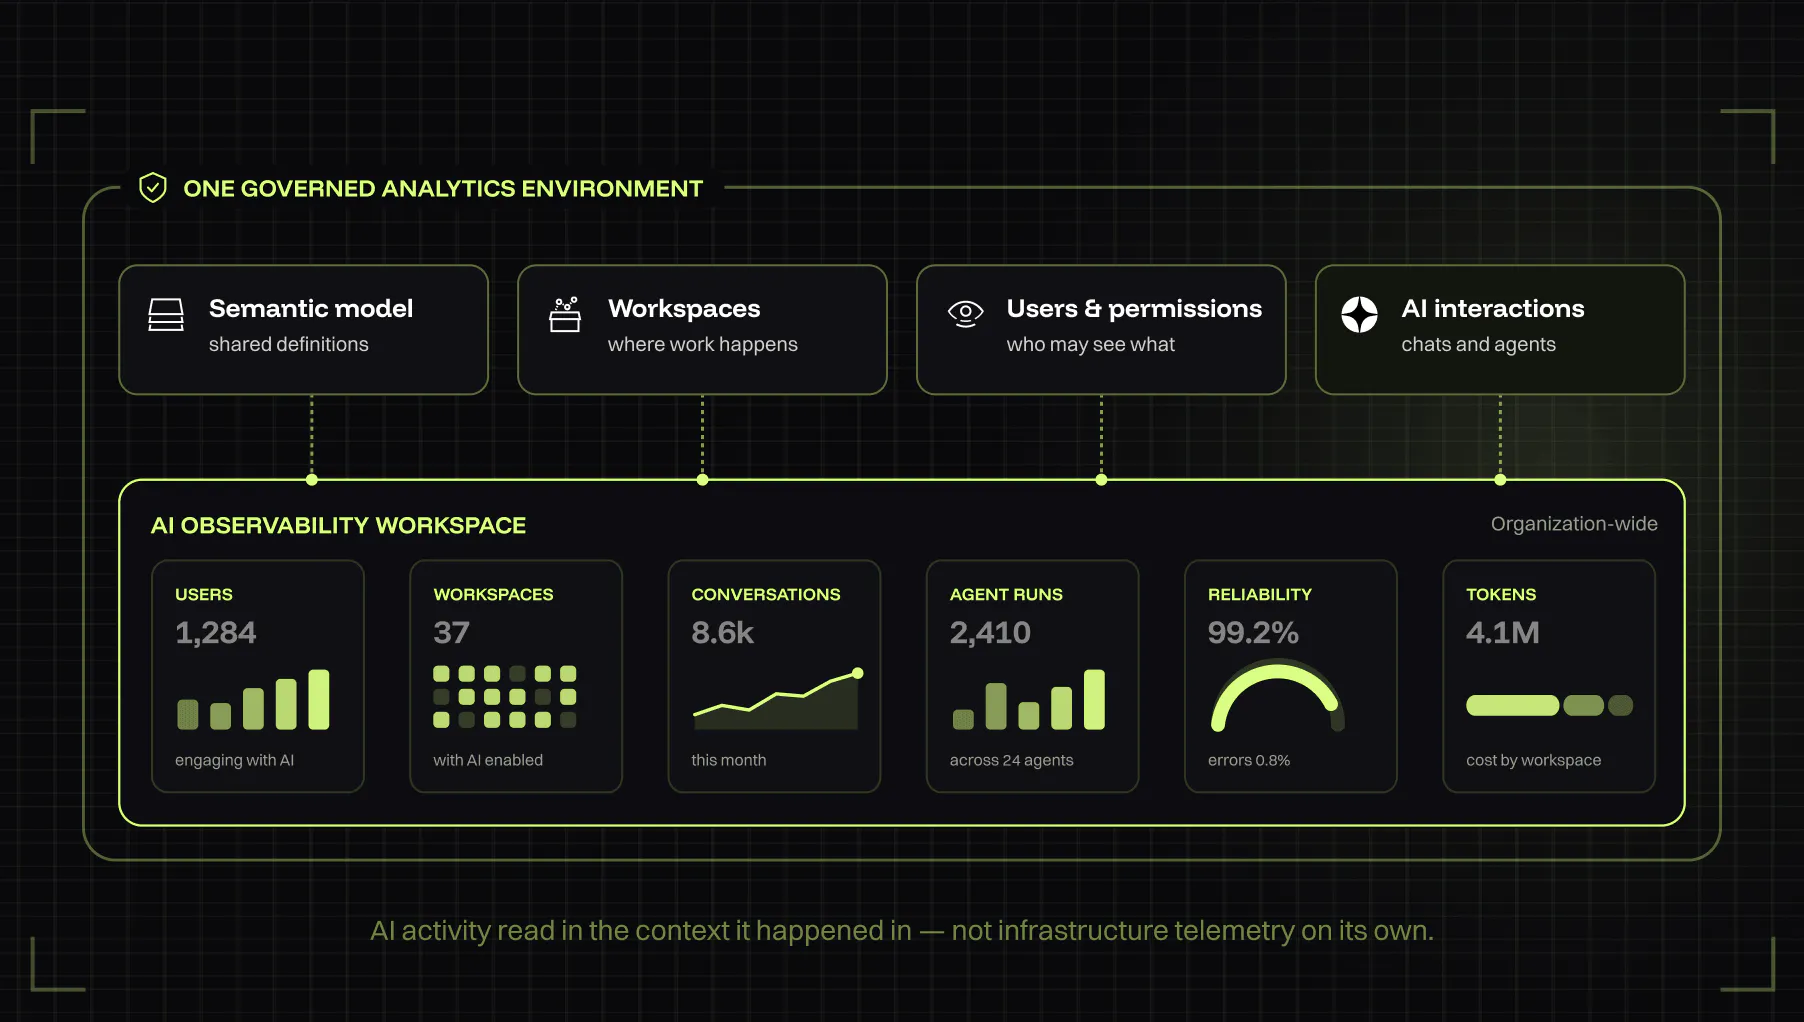
Eine Analyseplattform, auf der der Agent läuft, ist diesem Kontext oft deutlich näher, weil sie Konzepte wie Benutzer, Workspaces, Berechtigungen und das semantische Modell bereits verwaltet. Wird Observability auf dieser Ebene ergänzt, zeigt ein Trace nicht nur, was ein Tool-Aufruf zurückgegeben hat, sondern auch, was dieser Aufruf im Kontext der Workspace-Daten und der Rolle des Benutzers bedeutet.
Das ist nicht nur ein architektonisches, sondern auch ein praktisches Argument: Jedes zusätzliche Tool bringt Authentifizierung, Datenreplikation und ein weiteres Dashboard mit sich, das geprüft werden muss. Eine vollständige Aufschlüsselung dieses Aufwands und der Fälle, in denen er sich trotzdem lohnt, finden Sie im Artikel KI-Observability-Tools: Brauchen Sie ein separates Tool?. Für Teams, die Agenten bereits in einer Analyseplattform betreiben, führt der schnellste Weg zu Agenten-Observability in der Regel über die Prüfung, was diese Plattform bereits bereitstellt, bevor ein neues Tool hinzukommt.
Hinzu kommt der Datenschutz: Jedes externe Observability-Tool, an das Traces mit Prompts oder Kundendaten übermittelt werden, ist ein weiterer Auftragsverarbeiter im Sinne der DSGVO – mit eigenem Auftragsverarbeitungsvertrag (AVV) und bei Anbietern außerhalb der EU zusätzlich einer Prüfung der Drittlandübermittlung. Bleibt die Observability in der Plattform, in der Ihre Agenten ohnehin laufen, kommt kein zusätzlicher Verarbeiter hinzu. Und wird diese Plattform in Ihrer eigenen Infrastruktur betrieben, verlassen auch die Observability-Daten Ihre Umgebung nicht.
Das heißt nicht, dass ein dediziertes Observability-Tool nie die richtige Wahl ist. Teams, die eigene Agenten vollständig außerhalb einer bestehenden Plattform entwickeln – ohne ein System, das bereits Nutzungs- oder Workspace-Kontext vorhält –, sind genau der Fall, in dem sich ein dediziertes Tool lohnt. Entscheidend ist, ob dieser Kontext dort, wo Ihr Agent läuft, bereits vorhanden ist.
Best Practices für KI-Agenten-Observability
Einen Agenten von Anfang an sauber zu instrumentieren, ist weitaus günstiger, als ihn nach einem Produktionsvorfall nachzurüsten. Die folgenden Praktiken beschreiben die Reihenfolge, der die meisten Teams folgen.
Instrumentieren Sie vor dem Launch, nicht erst nach dem ersten Vorfall. Richten Sie das Tracing mit einem Standard wie den OpenTelemetry GenAI Semantic Conventions ein, bevor ein Agent in Produktion geht. So liefert der erste Fehler einen Trace statt eines Support-Tickets und einer Vermutung.
Verfolgen Sie jeden Tool-Aufruf, nicht nur das Endergebnis. Ein Trace, der nur die letzte Nachricht des Agenten erfasst, verbirgt genau die Informationen, die zum Debugging einer falschen Aktion nötig sind: welches Tool aufgerufen wurde, in welcher Reihenfolge und mit welchem Ergebnis.
Richten Sie Evaluierungs-Gates ein, bevor Sie die Nutzung skalieren. Automatisierte Evaluierungsscores oder die menschliche Prüfung einer Stichprobe von Interaktionen decken Qualitätsrückgänge auf, bevor sie alle Benutzer erreichen – und nicht erst, wenn sich genug Beschwerden angesammelt haben, um ein Muster zu erkennen.
Behandeln Sie Prompts, Antworten, Tool-Argumente, abgerufene Inhalte und das Agenten-Memory als potenziell sensible Telemetriedaten. Erfassen Sie sie nur bei Bedarf, setzen Sie geeignete Maskierung und Zugriffskontrollen ein und vermeiden Sie es, große Rohdaten-Payloads unterschiedslos zu indexieren. Da Prompts und abgerufene Inhalte häufig personenbezogene Daten enthalten, gelten für diese Telemetrie die Grundsätze der DSGVO, insbesondere Datenminimierung und Speicherbegrenzung. Legen Sie deshalb auch fest, wie lange Traces aufbewahrt werden.
Lösen Sie Alerts bei Verhaltensanomalien aus, nicht nur bei Fehlern. Ein Agent, der fünfmal hintereinander denselben Tool-Aufruf wiederholt oder für eine Routineaufgabe plötzlich doppelt so viele Schritte benötigt, hat keinen Fehler ausgelöst. Dennoch ist das ein Signal, das Sie erkennen sollten, bevor daraus ein Fehler wird.
Erfassen Sie Kosten und Anzahl der Iterationen pro Agent, nicht nur aggregiert. Ein einzelner fehlerhaft arbeitender Agent kann unbemerkt den Großteil der Token-Ausgaben oder Iterationen verursachen. Eine Aufschlüsselung pro Agent deckt das auf, lange bevor es als Überraschung auf der Monatsrechnung erscheint.
Wie GoodData.AI das Thema heute angeht
GoodData.AI versteht Observability als Teil derselben Plattform, auf der Analysen, Data Apps, Assistenten und Agenten gemeinsam laufen – und nicht als separates System, das konfiguriert und gewartet werden muss. Da alle Komponenten dasselbe semantische Modell und dieselbe Governance-Ebene nutzen, zeigt das Debugging einer fehlgeschlagenen Agentenaufgabe, wer betroffen war, welche Daten beteiligt waren und wie das mit den übrigen Analysen des Unternehmens zusammenhängt – und nicht nur, was ein einzelner Tool-Aufruf zurückgegeben hat. Zuverlässigkeitsprobleme, Token-Verbrauch und inkonsistentes Agentenverhalten erscheinen direkt neben dem Reporting, das Teams bereits nutzen, und werden als Teil der Plattform verwaltet statt als separater Stack.
Das gilt auch für Self-hosted-Bereitstellungen mit GoodData Cloud Native: Observability-Daten werden dort erfasst, wo auch Ihre Agenten laufen, und bleiben in Ihrer Umgebung. Wie sich KI-Analysen vollständig in Ihrer eigenen Infrastruktur betreiben lassen, lesen Sie im Artikel Datensouveränität und KI-Analysen: So bleibt Ihr LLM in Ihrer eigenen Infrastruktur.
Wie geht es weiter?
Agenten-Observability ist nicht einfach LLM-Observability mit mehr Schritten. Sie erfordert das Tracing des vollständigen Entscheidungspfads, die Behandlung jedes Tool-Aufrufs als nachverfolgbares Ereignis und genügend Kontext über den Workspace und die Daten, mit denen ein Agent gearbeitet hat. Nur so lässt sich beurteilen, ob eine Aktion richtig war – und nicht nur, ob sie ohne Fehler ausgeführt wurde.
Prüfen Sie, bevor Sie ein dediziertes Observability-Tool einführen, was Ihre bestehende Analyse- oder Agentenplattform bereits bereitstellt. Einen umfassenderen Überblick bietet der Artikel Was ist KI-Observability? Ein praktischer Leitfaden. Wie die Nutzung von Agenten mit Governance und Kostenverantwortung zusammenhängt, lesen Sie in KI-Governance beginnt mit dem Wissen, wer KI nutzt.
Wenn Ihr Team abwägt, ob ein dediziertes Tool für Agenten-Observability sinnvoll ist, erfahren Sie hier, wie die Agentic-Analytik-Plattform von GoodData.AI die KI-Nutzung ohne zusätzliche Einrichtung sichtbar macht. Oder fordern Sie eine Demo an, um die Plattform in Aktion zu erleben.
Erfahren Sie, wie GoodData.AI Ihnen hilft, Analytik, KI und Agenten auf einer einzigen Plattform zu entwickeln, zu steuern und zu skalieren.
Demo anfordern
Häufig gestellte Fragen
LLM-Observability konzentriert sich in der Regel auf Modellinteraktionen wie Prompts, Antworten, Tokens, Latenz und Qualität. Agenten-Observability erweitert diese Sicht auf die gesamte Abfolge von Modellaufrufen, Retrievals, Tool-Aufrufen und Iterationen, die zur Erledigung einer Aufgabe nötig sind.
Beginnen Sie mit Tool-Aufrufen und deren Ergebnissen. Zu wissen, welche Tools ein Agent in welcher Reihenfolge aufgerufen hat und was sie jeweils zurückgegeben haben, erklärt einen Fehler meist schneller, als jedes mögliche Ausführungsdetail zu erfassen.
Die GenAI Semantic Conventions von OpenTelemetry entwickeln sich zum herstellerneutralen Standard in diesem Bereich. Tool-Aufrufe sind darin bereits abgedeckt, für den Agenten-Lebenszyklus und Memory-Operationen gibt es ergänzende Community-Vorschläge. Ein standardisiertes Schema verhindert, dass Telemetriedaten an das proprietäre Format eines einzelnen Anbieters gebunden sind.
Nicht zwangsläufig. Wenn Ihre Agenten bereits in einer Plattform laufen, die über Nutzungs-, Workspace- und Datenkontext verfügt, prüfen Sie zunächst, was diese Plattform bereitstellt, bevor Sie ein separates Tool einführen. Dedizierte Tools sind vor allem für Agenten sinnvoll, die vollständig außerhalb einer bestehenden Plattform entwickelt werden.
Das Ergebnis ist die finale Antwort oder Aktion, die ein Agent liefert. Das Verhalten umfasst alles, was dazu geführt hat: welche Tools er aufgerufen hat, welche Daten er abgerufen hat und wie viele Schritte oder Iterationen er benötigt hat. Ein Agent kann auch über einen ineffizienten oder riskanten Weg zu einem korrekten Ergebnis gelangen.
Dass ein Agent eine falsche Aktion ausführt – und nicht nur eine falsche Antwort gibt. Sobald ein Agent Datensätze aktualisieren oder Workflows auslösen kann, kann ein unbemerkter Fehler in seinem Entscheidungspfad Folgen haben, die weit über eine schlechte Antwort auf dem Bildschirm hinausgehen.